

 02 • 34 • 09 • 31 • 70
Contexte de Dust
Dust est une plateforme française d’intelligence artificielle qui permet de créer sans code des skills ou des agents ayant accès à vos données (Google Drive, mails, Notion, Github, base de données…), et donc aux informations, contexte, terminologie et enjeux propres à l’entreprise. Pour en savoir plus sur la plateforme Dust, suivez ce lien.
Création de l'agent IA dans Dust
L'objectif de cet article est de vous montrer à travers un cas concret, le fonctionnement des agents et leurs apports potentiels.
Nous avons donc créé un agent simple capable de :
- Rédiger une fiche synthétique et structurée à partir de notes prises pendant une formation,
- La sauvegarder dans Notion
Interface de Dust
À noter : nous présentons dans cet exemple les écrans que nous avons utilisés, sans prétendre couvrir l’ensemble des possibilités offertes par Dust.
Pour commencer la création d’un agent IA dans Dust :
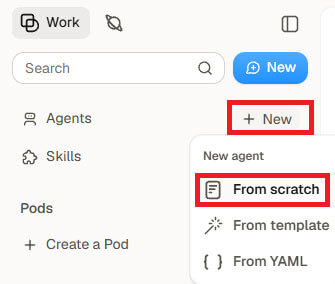
L'interface se divise ensuite en deux panneaux :
- Celui de gauche permet de définir le fonctionnement d’un agent,
- Celui de droite permet d'échanger avec Sidekick, l’assistant IA de Dust.
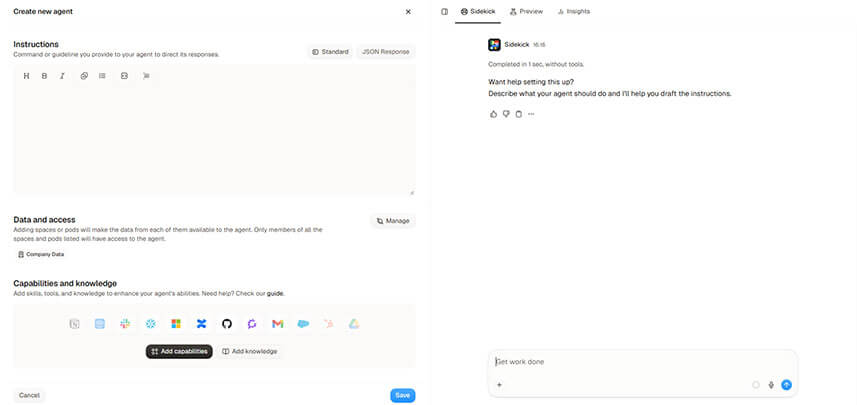
Dans le panneau de gauche :
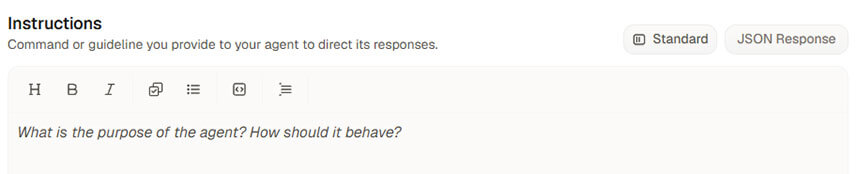
Dans la section Instructions, nous définissons le comportement de l’agent ainsi que le modèle (Basic, Standard, Premium, Claude Sonnet 4.6…) à utiliser.
À noter : Si le modèle n’a pas besoin d’être particulièrement performant, notamment pendant les phases de test, il peut être préférable de choisir le modèle Basic plutôt que Standard afin de limiter la consommation de tokens.
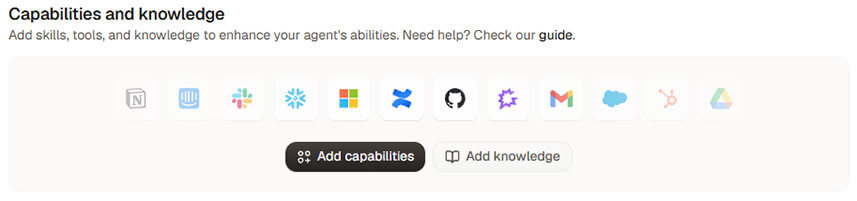
Dans la section Capabilities and knowledge, nous définissons les outils auxquels l'agent est autorisé à accéder.
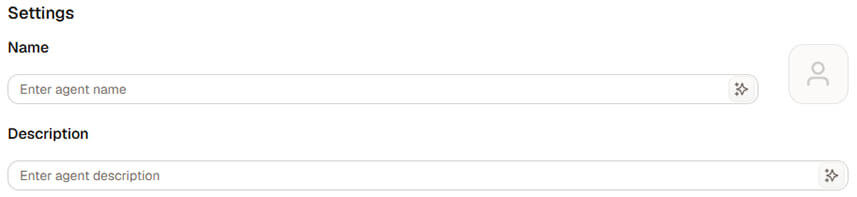
La section Settings permet de définir le nom et la description de l'agent.
Dans la liste des agents, on retrouve notamment leur nom, leur description, ainsi que le modèle utilisé.

Les étapes de la création de l'agent dans Dust
Nous avons principalement utilisé l’assistant Sidekick pour rédiger les instructions de l’agent que nous souhaitions créer. Nous lui avons expliqué que l’agent devait prendre en entrée des notes (formation, réunion…) et produire une fiche synthétique. Cette fiche devait respecter une trame précise, avec un titre et une en-tête contenant la date de prise de notes, le ou la formateur·ice, ainsi que la date de rédaction ou de dernière modification de la fiche.
La fiche devait ensuite présenter le concept abordé, les définitions associées, ce que nous semblions avoir appris à partir de nos notes, ainsi qu’un exemple illustrant un cas d’utilisation concret (par exemple, une requête HTTP GET). Nous souhaitions également faire apparaître quelques points à vérifier et une à trois questions permettant de tester notre compréhension et de nous inciter à approfondir le sujet. Sidekick nous a proposé d’ajouter une section « Concepts liés ».
Voici la trame complète :
- Titre
- Entête
- Date de formation
- Formateur·ice
- Date de modification
- Corps
- Concept
- Définition
- Ce que nous pensons avoir appris
- Exemple
- Concepts liés
- Points potentiellement faux ou imprécis
- Une à trois questions pour vérifier notre compréhension
Une fois la génération de la fiche mise en place, nous avons cherché à ajouter une Capability permettant de la sauvegarder. Nous avons alors découvert que nous n’avions pas encore accès à Notion. En attendant de pouvoir l’utiliser, nous avons contourné cette contrainte en nous appuyant sur les Capabilities Agent memory et Create Files pour assurer la persistance des données.
Nous nous sommes alors demandé comment basculer vers Notion par la suite. Dans une logique de séparation des responsabilités, nous avons choisi de créer un deuxième agent, ou sous-agent, dédié à la sauvegarde, tandis que le premier resterait responsable de la rédaction des fiches.
Le premier agent, que nous appellerons le Rédacteur, génère la fiche puis la transmet au second, que nous appellerons l’Archiviste, qui se charge de la sauvegarder. Ainsi, lorsque nous avons pu accéder à Notion, il nous a suffi de modifier le second agent pour qu’il utilise cette Capability à la place de Agent memory et Create Files.
Comme pour tout agent, il a ensuite fallu tester, observer les résultats et itérer jusqu’à obtenir le comportement souhaité. Lors de nos premiers tests, nous avons notamment constaté que rien n’était prévu pour mettre à jour les fiches existantes. Par exemple, si une fiche "Photosynthèse" existe déjà et que nous ajoutons l’information "aujourd’hui, nous avons appris que, à l’instar des végétaux, certains animaux réalisent aussi la photosynthèse", l’agent risque de créer une nouvelle fiche au lieu de mettre à jour celle qui existe. Avec l’aide de Sidekick, nous avons donc ajouté une fonctionnalité permettant de mettre à jour les fiches existantes.
Points d’attention
Une fois Notion ajouté dans les Capabilities, d’autres questions ont émergé, dont :
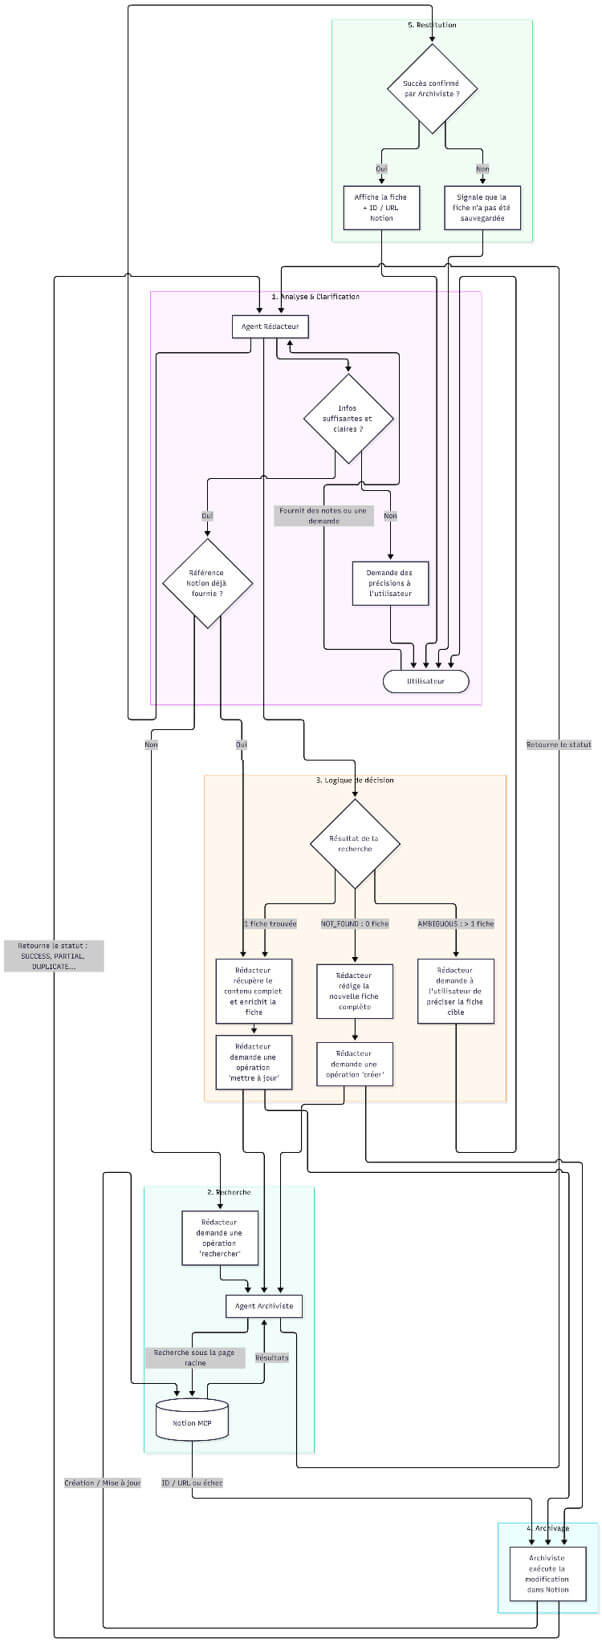
Quel agent met à jour une fiche existante ?
En théorie, ce devrait être la responsabilité de l’agent Rédacteur… mais dans les faits :
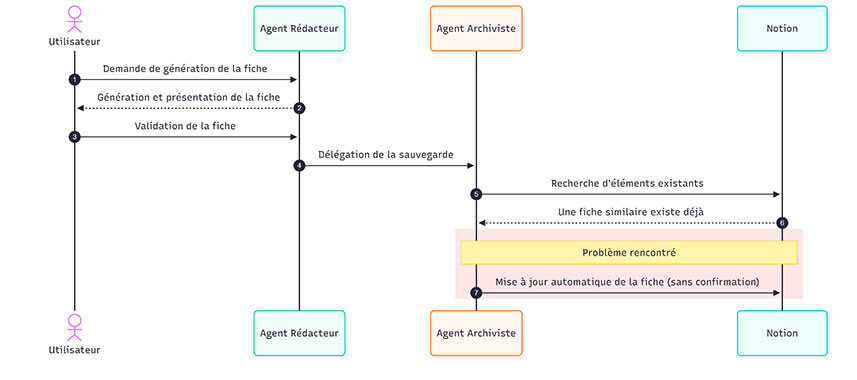
Une fois la tâche de sauvegarde déléguée à l’agent Archiviste, la main n’est plus rendue à l’agent Rédacteur. Il a donc fallu expliciter le comportement attendu des deux agents : si la fiche existe déjà, l’agent Archiviste doit confier sa mise à jour à l’agent Rédacteur qui lui renverra la version mise à jour pour qu'elle soit enregistrée dans Notion.
Mais dans ce cas, les agents ne risquent-ils pas de découvrir l’existence d’une fiche seulement après avoir généré une nouvelle fiche et tenté de la sauvegarder ?
Là encore, nous avons dû préciser le comportement attendu : l’agent doit commencer par vérifier si une fiche existe déjà.
- Si elle n’existe pas, il en crée une nouvelle.
- Si elle existe, il la met à jour.
- En cas de doute (fiche potentiellement correspondante ou plusieurs fiches connexes), il demande confirmation à l’utilisateur.
Diagramme de flux
Démonstration
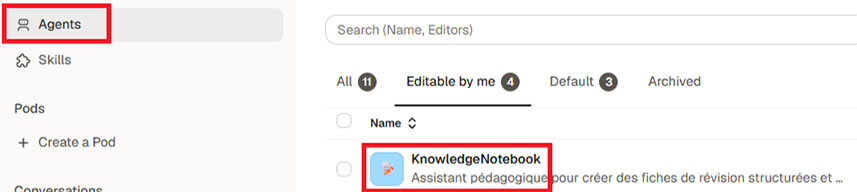
Une fois l’agent créé, nous accédons à la liste des agents disponibles en cliquant sur Agents dans le panneau de gauche, puis sélectionnons l’agent qui nous intéresse :
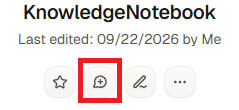
Un panneau s’ouvre sur la droite. Nous cliquons sur l’icône de discussion :
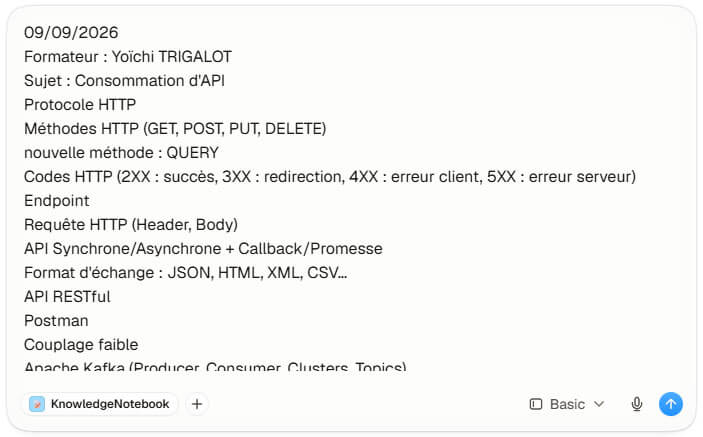
Un fil de discussion s’ouvre. Nous pouvons alors transmettre nos notes à l’agent, ici celles prises lors de la formation "Consommation d’API" :
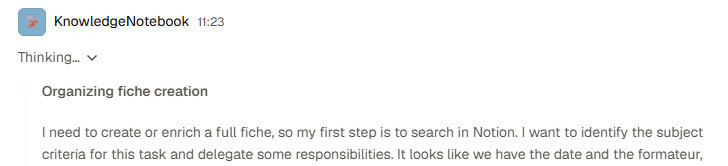
L’agent commence sa tâche :
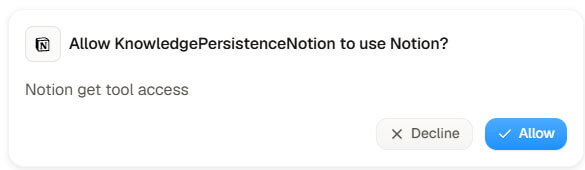
Il peut demander l’autorisation d’accéder aux outils que nous lui avons attribués :
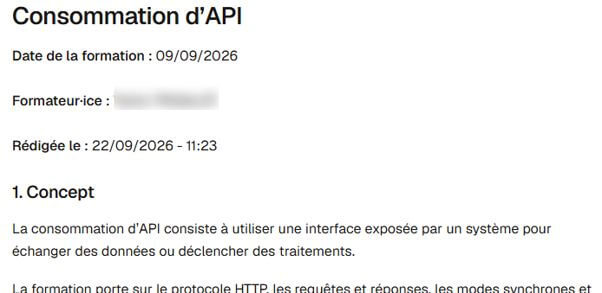
Il nous présente ensuite la fiche qu’il a rédigée :
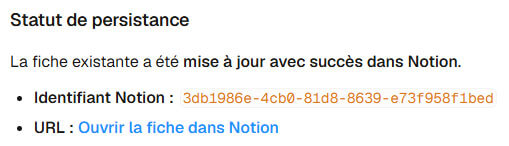
Il nous confirme que la fiche a bien été enregistrée dans Notion et fournit notamment le lien permettant d'y accéder.
Avantages et limites de cet agent
Avantages
L’agent Archiviste traite la fiche comme une donnée opaque qu’il ne peut pas modifier. Si le contenu de la fiche pose problème, il faut intervenir dans l’agent Rédacteur. De même, si la sauvegarde pose problème, c’est l’agent Archiviste qui en est responsable. Ce découplage permet de faire évoluer un agent sans impacter l'autre. Nous avons ainsi pu faire évoluer le mécanisme de persistance (mémoire + fichiers → Notion) sans modifier la logique de rédaction.
Le Rédacteur ne peut pas confirmer une sauvegarde qui n’aurait pas réellement eu lieu : il ne considère l'opération comme réussie que lorsque l'Archiviste lui renvoie explicitement un statut SUCCESS.
La fiche générée peut servir de support pédagogique actif. Elle ne cherche pas à combler artificiellement les éventuels vides hors périmètre, met en évidence certains points à vérifier et propose des questions permettant de tester les limites de notre compréhension du sujet.
L’Archiviste peut par ailleurs être réutilisé, puisque ses fonctionnalités ne dépendent pas du contenu du document qu’il archive dans Notion. Il pourrait ainsi servir à sauvegarder des comptes rendus, des notes ou tout autre type de document.
Limites
Le découplage implique des allers-retours entre les différents agents et peut donc ralentir l’exécution de la tâche, qui prend pour le moment moins d’une minute.
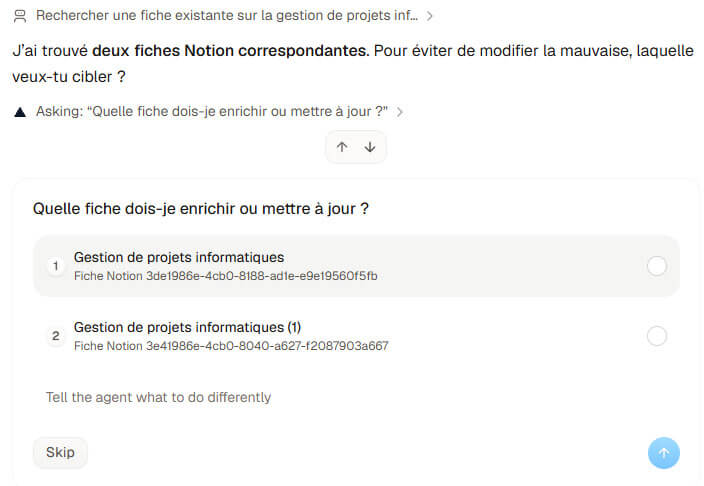
La recherche de fiches portant sur un sujet similaire, basée sur du "fuzzy matching", peut entraîner des faux positifs ou des faux négatifs : l’agent pourrait par exemple retourner un statut NOT_FOUND et créer un doublon, ou au contraire rapprocher deux sujets différents. Pour le moment, nous n’avons pas rencontré ce problème. Alors qu’une fiche "Gestion de projets informatiques" existait déjà, nous avons essayé de créer une fiche "IT Project Management" portant sur un contenu différent. Malgré la différence de langue, l’agent a correctement identifié que le sujet avait déjà été traité :
La trame reste perfectible et assez rigide : elle n’est pas toujours adaptée au sujet ou à la quantité de contenu disponible. Avec peu d’informations, l’agent peut chercher à remplir l’ensemble des sections et générer du contenu redondant, avec notamment des mentions telles que "Non précisé" ou "À compléter".
Le coût
- Lorsqu’une fiche est mise à jour, l’Archiviste renvoie son contenu au Rédacteur. Le contexte de ce dernier s’allonge alors, puisqu’il doit conserver les nouvelles notes à intégrer, le contenu de la fiche existante ainsi que l’historique éventuel de la conversation. Il s’agit des Input tokens.
- Pour conserver une structure claire et un contenu cohérent, le Rédacteur réécrit ensuite l’intégralité de la fiche à partir de ce contexte. Or, les Output tokens (tokens générés en sortie) peuvent parfois coûter plus cher que ceux consommés en entrée.
Nous pourrions demander à l’agent d’effectuer un patch ou un append afin de limiter cette consommation, mais au risque d’obtenir une fiche moins claire et moins structurée. Pour cet agent, nous avons donc choisi de privilégier la cohérence du contenu par rapport au coût. Pour un historique, par exemple, une approche en append nous semblerait en revanche plus pertinente.
Cette expérimentation nous a permis de passer d’un cas d’usage simple - transformer des notes en fiche structurée - à une architecture multi-agents capable de créer, mettre à jour et archiver des connaissances dans Notion. L’intérêt de Dust ne réside donc pas uniquement dans la génération de contenu, mais aussi dans la possibilité de structurer des agents spécialisés et de leur faire collaborer à partir de responsabilités clairement définies.
Conclusion
Au-delà de l’automatisation de la prise de notes, nous obtenons ainsi un véritable support de capitalisation des connaissances, qui peut évoluer avec nos besoins. Les limites identifiées - gestion des doublons, rigidité de la trame ou consommation de tokens - montrent néanmoins que la conception et l’itération restent essentielles pour obtenir un agent fiable et pertinent.
Cette approche pourra par ailleurs être transposée à d’autres usages : comptes rendus, documentation, notes techniques ou tout autre contenu nécessitant à la fois une synthèse et une conservation structurée. La séparation entre rédaction et persistance facilite notamment cette réutilisation et permet de faire évoluer chaque composant indépendamment.
Vous souhaitez bénéficier d'experts, de développeurs, ou d'une formation sur Dust ? Rendez-vous sur la page Contact


